인공지능(AI) 데이터 및 솔루션 전문기업 플리토(대표 이정수)가 AI 모델의 다국어 인식 성능 향상을 위해 고품질 아랍어 음성 데이터를 수집하는 신규 프로젝트를 시작했다.
이번 프로젝트는 음성인식(Speech To Text, STT) 모델의 대표적인 취약 언어로 꼽히는 아랍어의 인식률을 개선하고, 지역별 방언 차이를 체계적으로 데이터화하기 위해 기획됐다. 아랍어는 표준어(Modern Standard Arabic, MSA) 외에도 30개 이상의 방언이 존재하며, 실생활에서는 표준어와 방언을 혼용하는 ‘코드 스위칭(Code-Switching)’ 현상이 빈번해 고난도의 데이터 구축 역량이 요구된다.
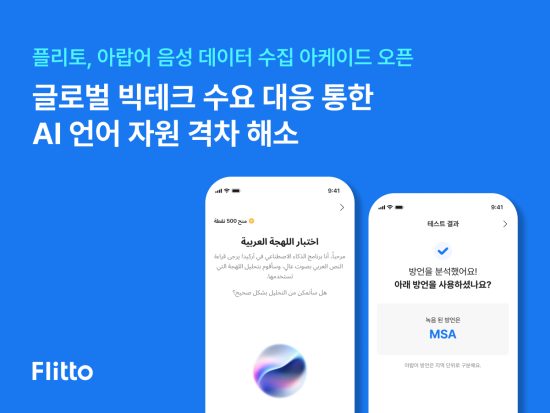
플리토는 자사 플랫폼인 ‘아케이드(Arcade)’를 통해 아랍어 원어민 유저들이 참여하는 실사용 음성 데이터를 수집 중이다. 참여자가 제시된 문장을 녹음하면 AI 시스템이 발화 데이터를 분석해 방언 유형을 자동 판별한다. 판별 결과가 불확실할 경우 추가 문장을 제시해 데이터의 정확도를 높이는 검증 프로세스를 구축했다.
최근 글로벌 빅테크 기업을 중심으로 다국어 음성 데이터 수요가 급증함에 따라, 플리토는 프로젝트 요청 증가에 대응하고 향후 잠재 시장을 선점하기 위해 이번 프로젝트를 추진하게 됐다.
이정수 플리토 대표는 “아랍어는 전 세계 4억 명 이상이 사용하는 주요 언어지만, 사용 인구에 비해 AI 학습용 데이터가 적은 저자원 언어에 속한다”며, “기술적으로는 여전히 다루기 어려운 언어지만, 이번 프로젝트를 통해 아랍어 고유의 특성과 실제 사용 맥락을 체계적으로 반영한 데이터 구축으로 글로벌 AI 모델의 아랍어 인식 품질을 한층 끌어올리는 데 기여하겠다”고 밝혔다.
플리토는 이번 수집을 통해 발화 패턴, 억양, 어휘 선택 등 언어적 다양성이 확보된 정교한 학습용 데이터셋을 구축할 예정이다. 이를 바탕으로 언어 자원 불균형에 따른 AI 편향성을 완화하고, 실사용 환경에서 신뢰도 높은 인식률을 구현하는 데이터 솔루션으로 발전시킨다는 방침이다.
이미지 제공: 플리토