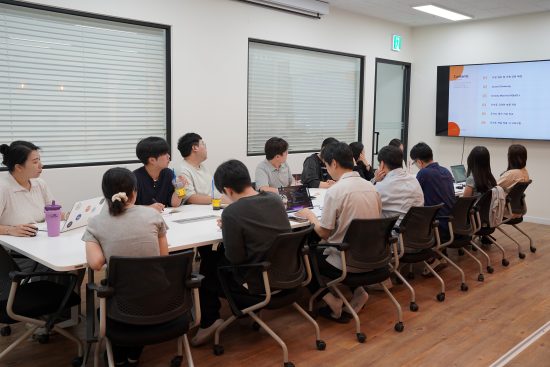
인공지능(AI)과 대형 언어 모델(LLM)의 확산으로 생성 텍스트의 정확도 검증과 고난도 비정형 데이터 가공 역량이 소프트웨어 테스팅 분야의 핵심 경쟁력으로 부상한 가운데, 소프트웨어 테스팅 전문 기업 와이즈스톤이 본사 대회의실에서 ‘사내 테크 세미나(Tech Seminar)’를 개최했다. 이번 세미나는 현장 테스터들의 기술적 통찰력을 높이고 품질 검증 역량을 고도화하기 위해 마련됐으며, LLM 텍스트 유사도 평가 방법론과 비정형 데이터 품질 검증 실무 노하우를 중심으로 진행됐다.
첫 번째 세션에서는 LLM 기반 대화형 제약·메디컬 서비스 소프트웨어의 성능 평가 사례를 바탕으로 텍스트 유사도 평가 지표의 실무 적용 방안이 다뤄졌다. 발표에서는 약물 프로필과 같은 복합 산업 데이터의 경우 단어 나열형과 서술형 문장이 혼재되어 있어, 데이터의 형태와 배열 순서를 고려하지 않고 단일 평가 지표에만 의존할 경우 모델 성능이 왜곡될 수 있다는 점이 지적됐다. 이에 연구진은 텍스트의 고유 특성과 평가 목적을 분석한 뒤 다양한 유사도 지표를 유연하게 융합 적용하는 정교한 측정 방법론을 대안으로 제시했다.
두 번째 세션에서는 STEM(과학·기술·공학·수학) 전문도서 프로젝트를 기반으로 AI 학습용 비정형 데이터 검증 방법론을 논의했다. 문서 변환 과정에서 수학 기호와 수식 등 비정형 데이터의 원본 훼손을 방지하기 위해, 원본 수식 이미지와 변환된 구조적 수식 데이터를 자동으로 비교하는 스크립트 기반 검증 체계가 소개됐다. 특히 전 과정을 기계에 의존하기보다 자동화 과정에서 오류로 분류된 데이터만 선별해 육안으로 점검하는 하이브리드 방식을 적용해 검증 효율성과 정확도를 동시에 확보한 실무 사례가 공유됐다.
와이즈스톤 관계자는 “이번 세미나에서 공유된 내용은 급변하는 AI 텍스트 생성 및 비정형 데이터 환경에서 테스터들이 체감한 실질적 한계를 극복하기 위한 방법론적 고민의 결과”라며 “단일 지표나 단순 기계적 자동화에 머무르지 않고 데이터의 구조와 목적에 맞춘 입체적 검증 체계를 구축하는 것이 핵심 경쟁력인 만큼, 사내 기술 교류를 지속해 AI 테스팅 역량을 내재화하겠다”고 설명했다.
이미지 제공: 와이즈스톤